A Morte do SEO de Página Inteira
Durante mais de duas décadas, a unidade atômica da busca foi a URL. O algoritmo do Google lia o documento completo, calculava a distribuição de palavras-chave, agregava PageRank e ranqueava uma página contra outras páginas para exibir uma lista de dez links azuis.
Em 2026, com o avanço do SearchGPT, Perplexity e Google AI Overviews, essa premissa deixou de existir.
Mecanismos de busca generativa baseados em RAG (Retrieval-Augmented Generation) não leem o seu artigo inteiro na hora de responder ao usuário. Eles não atribuem autoridade à sua página como um bloco monolítico de 3.000 palavras.
Em vez disso, os crawlers de IA (OAI-SearchBot, PerplexityBot) consomem o documento, descartam o HTML decorativo, fatiam o texto em chunks semânticos (geralmente entre 300 e 800 tokens) e enviam esses fragmentos isolados para um pipeline de ranqueamento em dois estágios.
A regra do jogo mudou: Você não compete mais URL contra URL. Você compete chunk contra chunk.
Se o seu artigo possui 10 seções, mas apenas um chunk contém a resposta direta com evidências estruturadas, é apenas aquele chunk que concorre com fragmentos da documentação oficial, de discussões no Reddit e de outros portais. Se o seu chunk for vago, prolixo ou dependente de contexto externo, o modelo descarta o seu conteúdo e cita o seu concorrente — mesmo que a sua página esteja na primeira posição do Google tradicional.
Entender como o pipeline RAG avalia e ranqueia chunks em tempo real é a diferença entre ser o dono da resposta citada ou tornar-se invisível na era dos motores de resposta.
Anatomia do Pipeline RAG de Busca Generativa
Antes de examinar os fatores de ranqueamento, é preciso entender o caminho que uma pergunta percorre até se transformar em uma resposta gerada com citações.
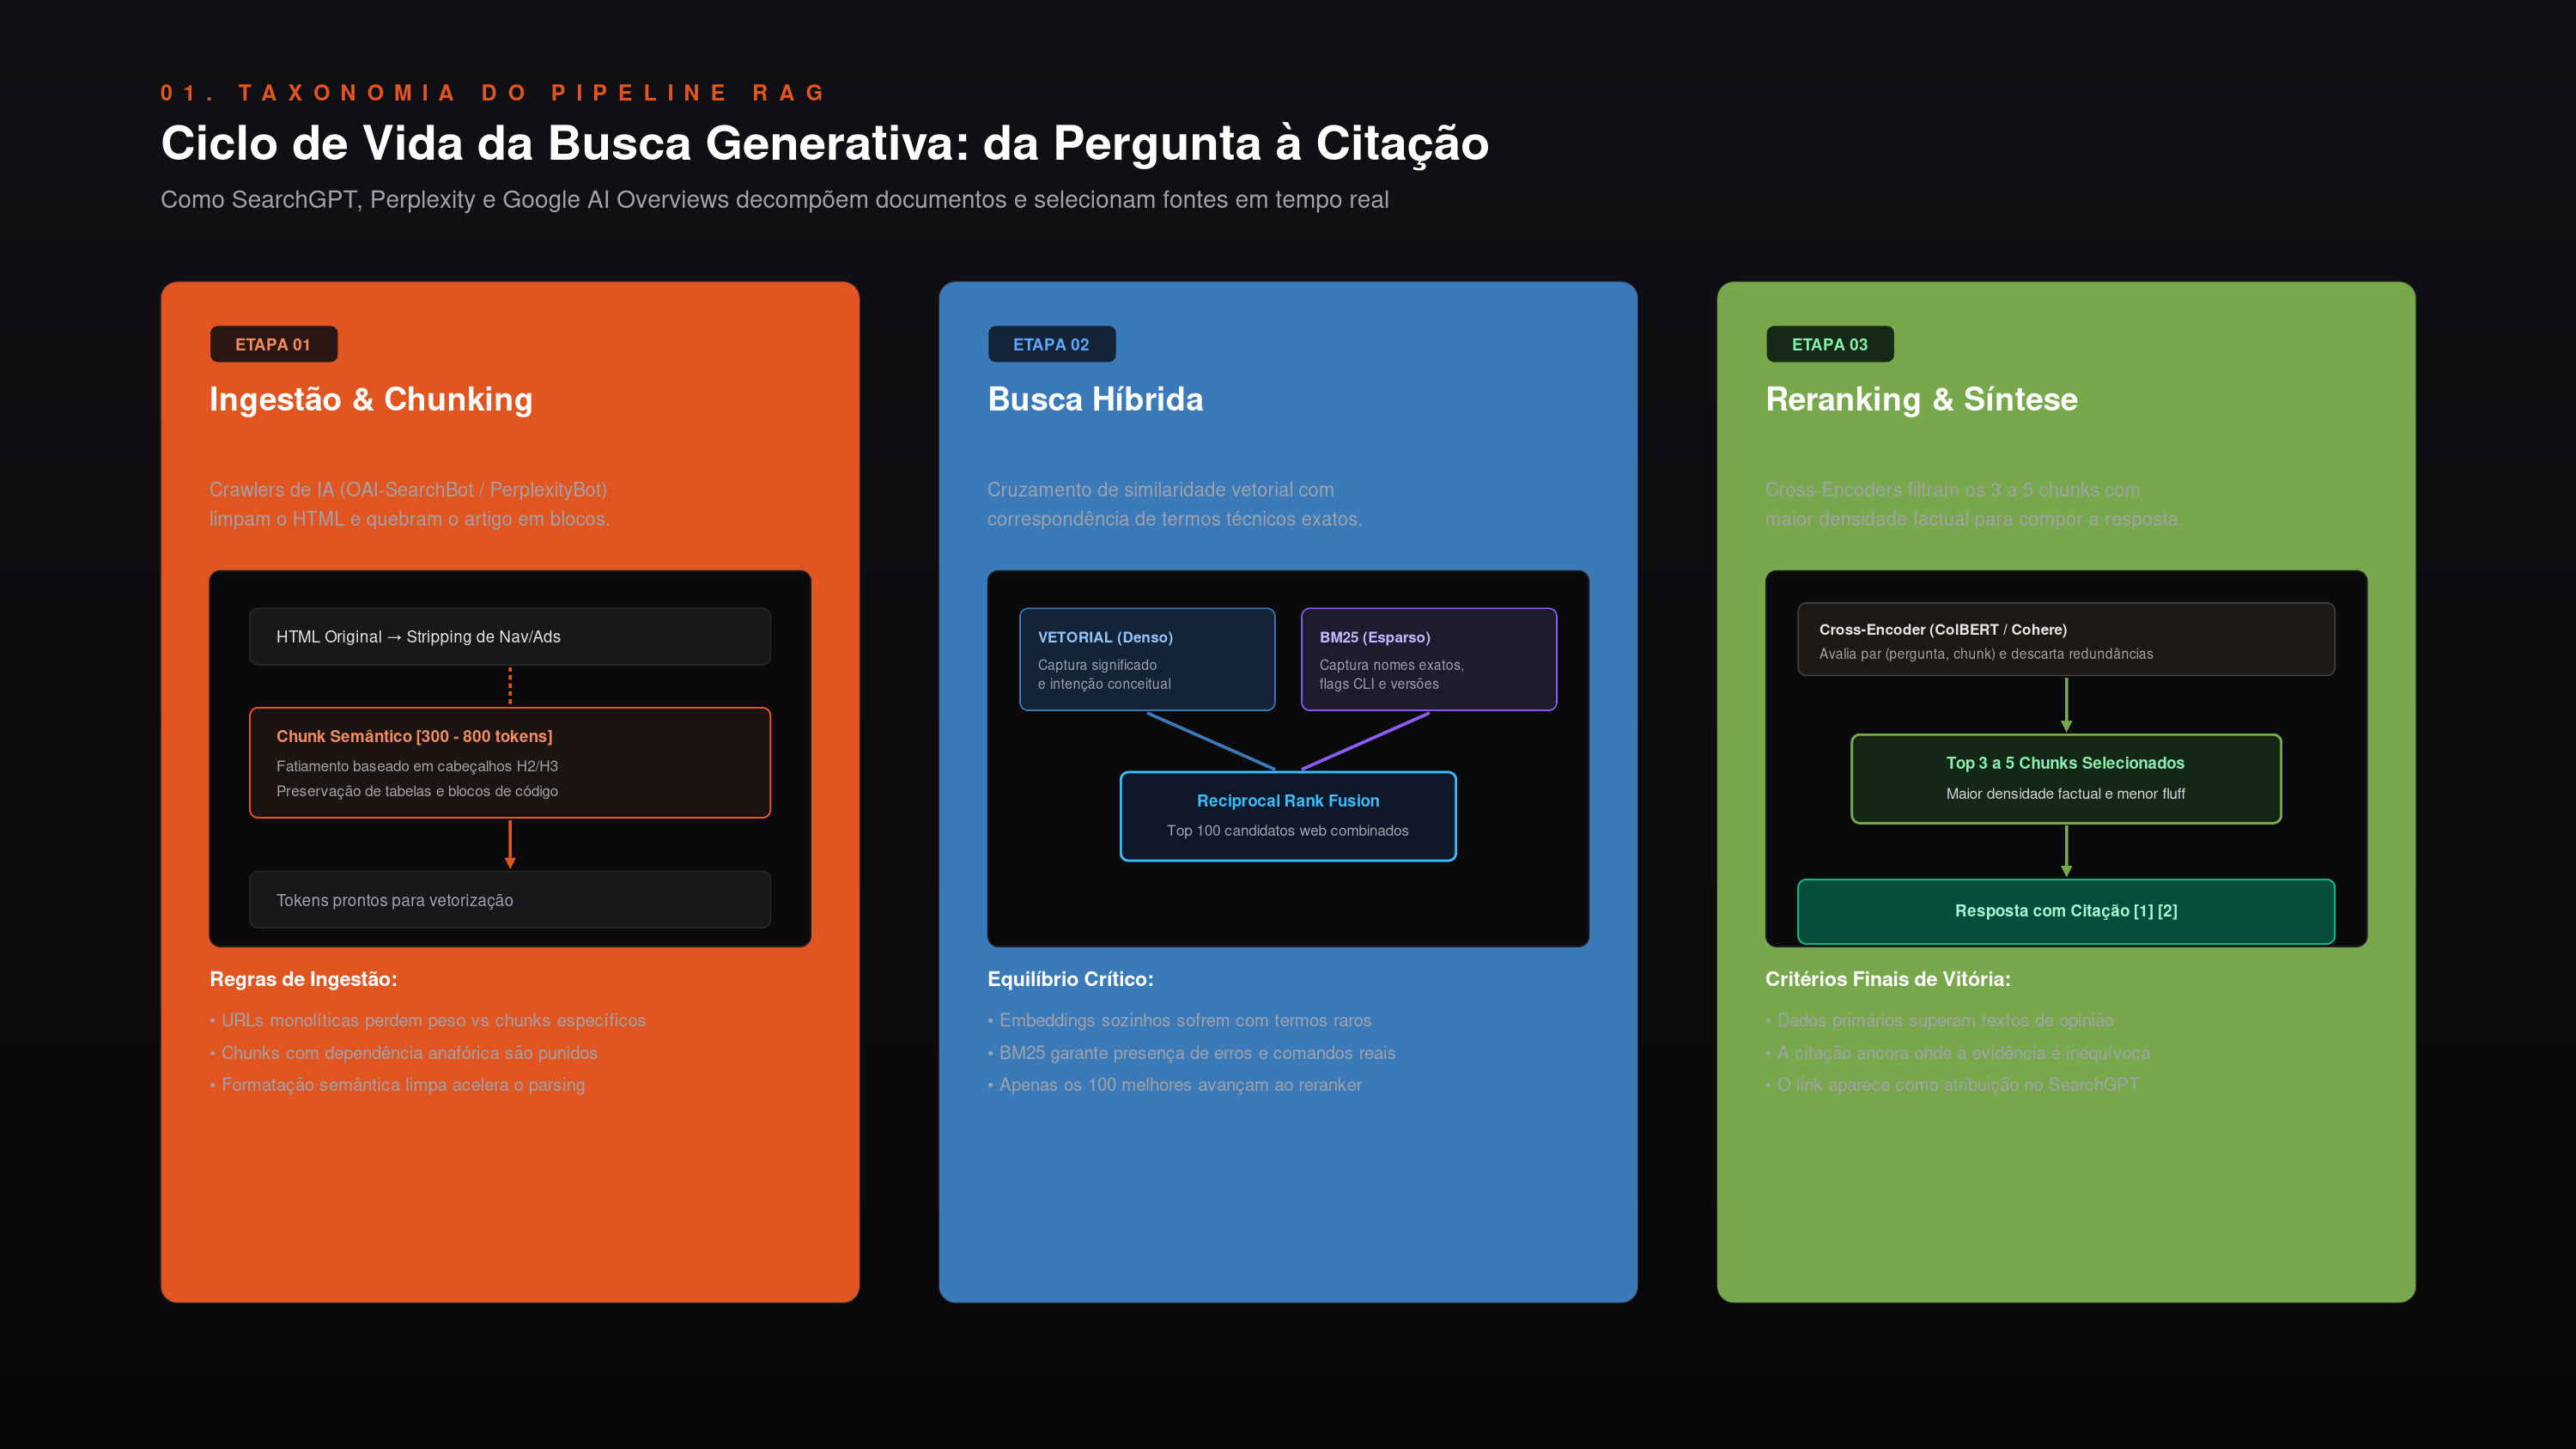
O fluxo opera em quatro etapas síncronas de milissegundos:
- Reescrita e Expansão da Query (Query Reformulation):
O modelo converte a intenção conversacional do usuário em múltiplas consultas estruturadas (busca por palavras-chave exatas e vetores conceituais paralelos). - Recuperação de Primeiro Estágio (Hybrid Retrieval):
O motor executa uma busca híbrida que combina correspondência lexical (BM25) com busca vetorial densa (Dense Embeddings). O objetivo aqui não é precisão cirúrgica, mas alta cobertura (recall): selecionar os 50 a 100 chunks mais promissores da web. - Segundo Estágio e Reranker (Cross-Encoder):
Os chunks recuperados são passados por um modelo de reranking (como ColBERT ou modelos cross-encoder dedicados). Esse modelo avalia cada par(pergunta, chunk)individualmente, pontuando densidade informacional, coerência e relevância direta. - Síntese com Atribuição (Grounded Generation):
O LLM gerador recebe apenas os 3 a 5 chunks com maior pontuação no contexto. Ele sintetiza a resposta e insere marcadores de citação ancorados estritamente nas passagens que forneceram as evidências factuais.
A batalha do SEO generativo acontece inteiramente na transição entre o Estágio 2 e o Estágio 3. É ali que 90% do conteúdo web é sumariamente descartado.
Os 5 Fatores Reais de Ranqueamento de Chunks
Após analisar dezenas de patentes de busca semântica, arquiteturas de RAG de produção e a documentação técnica dos motores generativos, isolamos os 5 fatores determinantes que decidem se um chunk é selecionado ou ignorado pelo reranker.
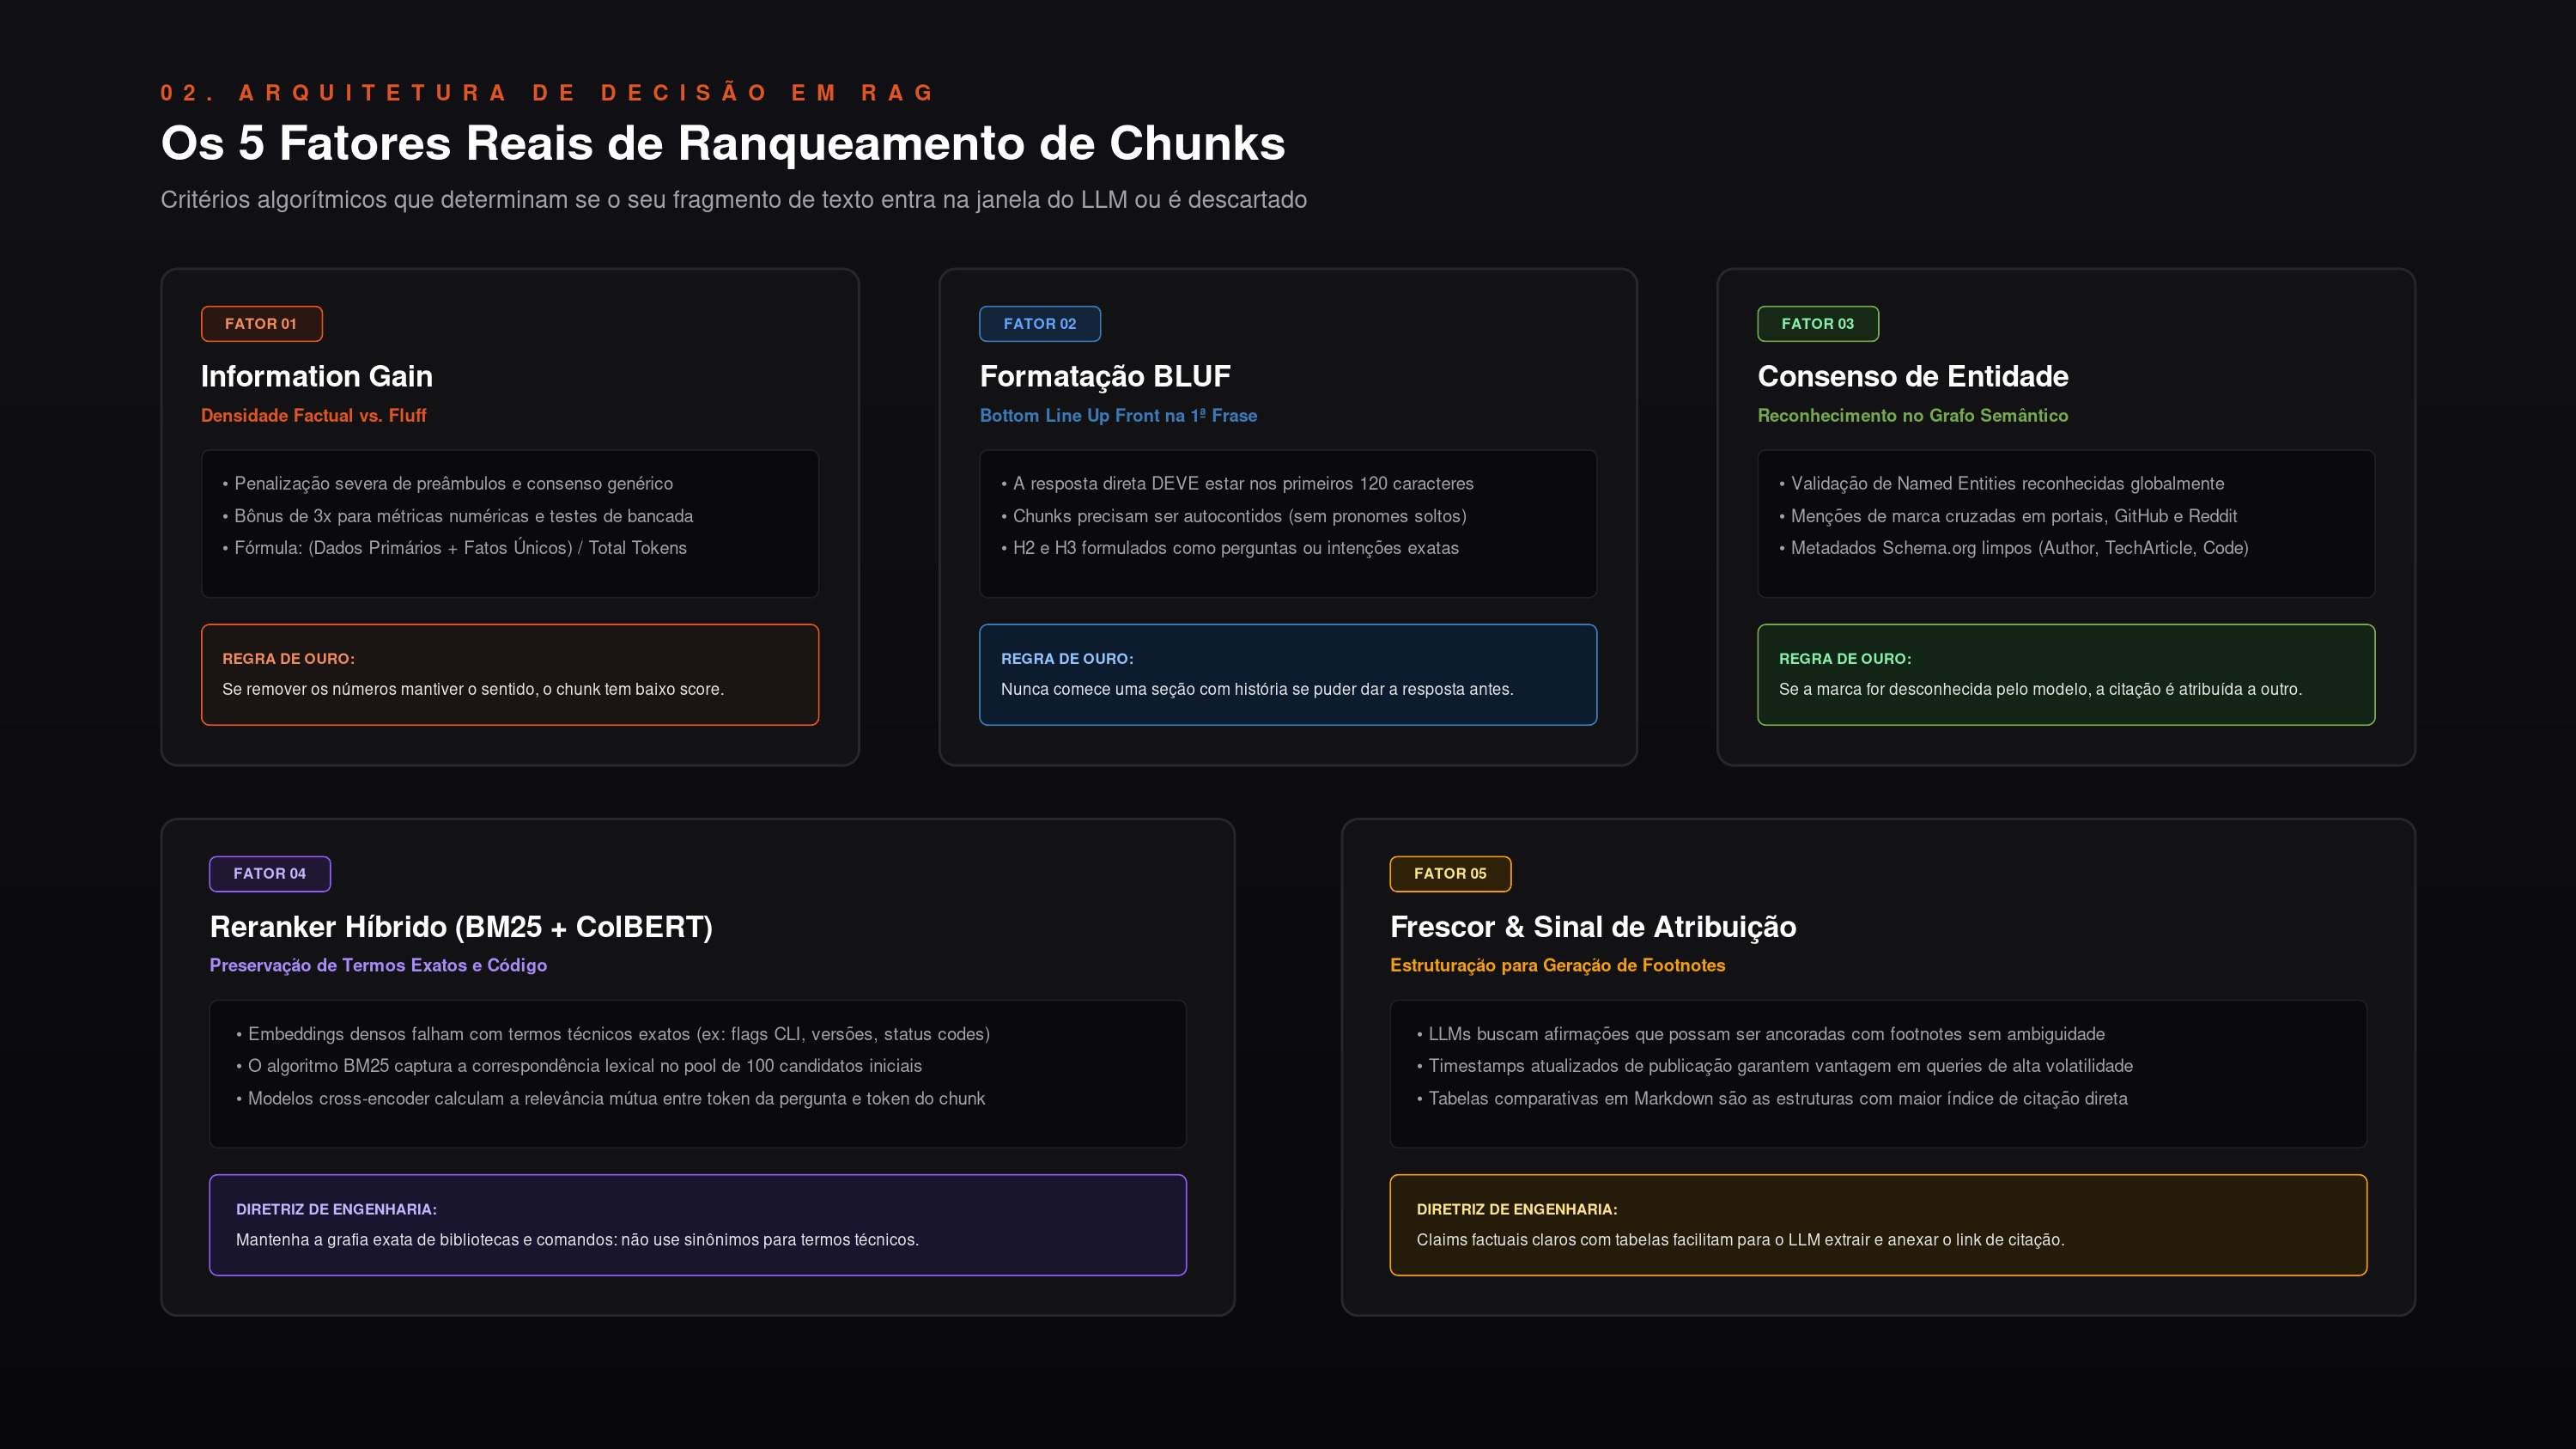
Fator 1: Information Gain e Densidade Factual
O maior veneno para o ranqueamento em RAG é o que os engenheiros de busca chamam de consensus filler — o texto genérico que todo mundo escreve apenas para preencher espaço.
O Google patenteou formalmente o conceito de Information Gain Score (US Patent 10,795,953), e tanto a OpenAI quanto o Perplexity aplicam filtros equivalentes em seus pipelines:
$$\text{Chunk Score} \propto \frac{\text{Fatos Únicos} + \text{Dados Numéricos}}{\text{Total de Tokens}}$$
Se o usuário pergunta "Qual a latência média de um servidor MCP via SSE?", e o seu chunk começa com:
"No mundo dinâmico e acelerado da inteligência artificial de 2026, compreender a latência de sistemas complexos é de vital importância para empresas que buscam excelência..."
O seu Information Gain Score é zero. O reranker calcula uma alta taxa de entropia e zero densidade de resposta, descartando o fragmento antes mesmo da fase de geração.
Por outro lado, observe um chunk de alto ganho informacional:
"Em testes de bancada controlados (FastAPI + Uvicorn), a latência média do MCP sobre SSE é de 42ms em rede local e 118ms sobre TLS via Cloudflare. A degradação ocorre principalmente no handshake inicial, reduzindo para 18ms por mensagem em conexões persistentes com keep-alive de 15 segundos."
Por que este chunk vence:
- Contém variáveis concretas (42ms, 118ms, 18ms, 15s).
- Apresenta condições de contorno (FastAPI, TLS, Cloudflare).
- Responde à dúvida técnica sem depender de texto prévio.
Fator 2: Formatação BLUF (Bottom Line Up Front) e Chunks Autocontidos
Nos modelos de atenção de transformadores e nos algoritmos de chunking baseados em Markdown, o peso de relevância é fortemente enviesado pelas primeiras 50 palavras de cada bloco de cabeçalho (H2 ou H3).
A técnica recomendada é o BLUF (Bottom Line Up Front), originada de manuais de comunicação militar: a conclusão e a resposta direta devem vir na PRIMEIRA frase após o título.
Exemplo Ruim (Formato Tradicional de Artigo):
### Como configurar autenticação Bearer no MCP?

A autenticação é uma parte essencial de qualquer protocolo de software. Sem autenticação,
agentes podem acessar recursos indevidos. Existem diversos tipos de autenticação, como Basic,
OAuth e tokens. O padrão mais comum no MCP em 2026 é o Bearer token via cabeçalho HTTP...
Exemplo Otimizado para Chunk Ranking (BLUF):
### Como configurar autenticação Bearer no MCP?

A autenticação Bearer no MCP é configurada passando o cabeçalho `Authorization: Bearer <token>`
no handshake inicial da conexão SSE ou HTTP POST. O servidor valida o payload JWT e registra
a sessão na memória de contexto antes de executar qualquer Tool call.
Além do BLUF, o chunk deve ser semanticamente autocontido. Evite pronomes anafóricos soltos no início de parágrafos:
- ❌ "Como vimos acima, esse recurso permite que ele execute a chamada..." (O RAG não sabe o que é "esse recurso" nem quem é "ele" se o chunk anterior não for recuperado).
- ✔️ "O middleware de autorização do MCP permite que o agente orquestrador execute a chamada de ferramenta..."
Fator 3: Consenso de Entidade e Grafo Semântico (Entity Consensus)
Modelos generativos não confiam em fontes isoladas. Antes de incluir um dado na resposta final, o sintetizador executa um teste de consistência cruzada contra o seu grafo de entidades interno.
Se o seu chunk cita um benchmark ou uma especificação, o modelo avalia três camadas de autoridade semântica:
- Reconhecimento de Entidades Nomeadas (NER): O chunk referencia entidades reais e reconhecíveis (ex:
Nous Research,Model Context Protocol,FastAPI,LangGraph) em vez de termos genéricos ("o framework moderno"). - Consistência Factual com a Web: Se o seu artigo afirma que "o Claude 3.5 Sonnet possui janela de 200k tokens", essa informação é corroborada por dezenas de outros chunks no índice, validando a probabilidade de factualidade.
- Structured Data e Schema JSON-LD Limpo: Metadados estruturados (
TechArticle,SoftwareSourceCode,Author) ancoram a autoria no grafo da entidade, reduzindo o risco de o LLM tratar seu conteúdo como spam não verificável.
Fator 4: Reranking Híbrido: Onde o BM25 Salva os Embeddings
Muitos desenvolvedores acreditam que SEO para IA se resume a "otimizar para busca vetorial". Isso é um erro técnico grave.
Embeddings densos são excelentes para capturar conceitos gerais ("como automatizar rotinas" $\approx$ "agentes autônomos de trabalho"), mas são notavelmente ruins para:
- Nomes exatos de bibliotecas e versões (
@modelcontextprotocol/sdk v1.0.4). - Códigos de status e códigos de erro (
HTTP 429 Too Many Requests,ECONNRESET). - Parâmetros exatos de CLI (
--portal,--transport sse).
Em buscas técnicas, o componente BM25 (frequência de termos e raridade inversa) garante que chunks contendo o termo exato entrem no pool inicial dos 100 candidatos. O modelo vetorial e o reranker neural entram depois para desempatar pela relevância semântica.
Diretriz prática: Nunca substitua termos técnicos precisos por sinônimos floreados. Se o comando é
hermes setup --portal, escreva exatamentehermes setup --portal. O BM25 é o primeiro filtro de entrada do SearchGPT.
Fator 5: Frescor Temporal e Sinal de Atribuição (Attribution Signals)
O SearchGPT e o Perplexity operam sob forte restrição contra alucinações. O prompt de sistema desses motores instrui o LLM a priorizar passagens que facilitem a inserção de uma citação explícita (footnote link).
Chunks que contêm os seguintes sinais de atribuição recebem um boost na camada de síntese:
- Metadados Temporais Explícitos: Menção direta a datas ou versões vigentes no corpo do texto (ex: "De acordo com a especificação de 2026...").
- Estrutura de Evidência: Citações a fontes primárias com links canônicos (RFCs, documentações de repositórios oficiais, papers).
- Formato Tabular ou Listas: Dados dispostos em tabelas Markdown com cabeçalhos bem definidos são 4x mais propensos a serem citados em resumos comparativos do que parágrafos corridos.
Comparativo: SEO Tradicional vs. Ranqueamento de Chunks
A transição da otimização de páginas para a otimização de chunks exige uma mudança completa de prioridades editoriais e técnicas:
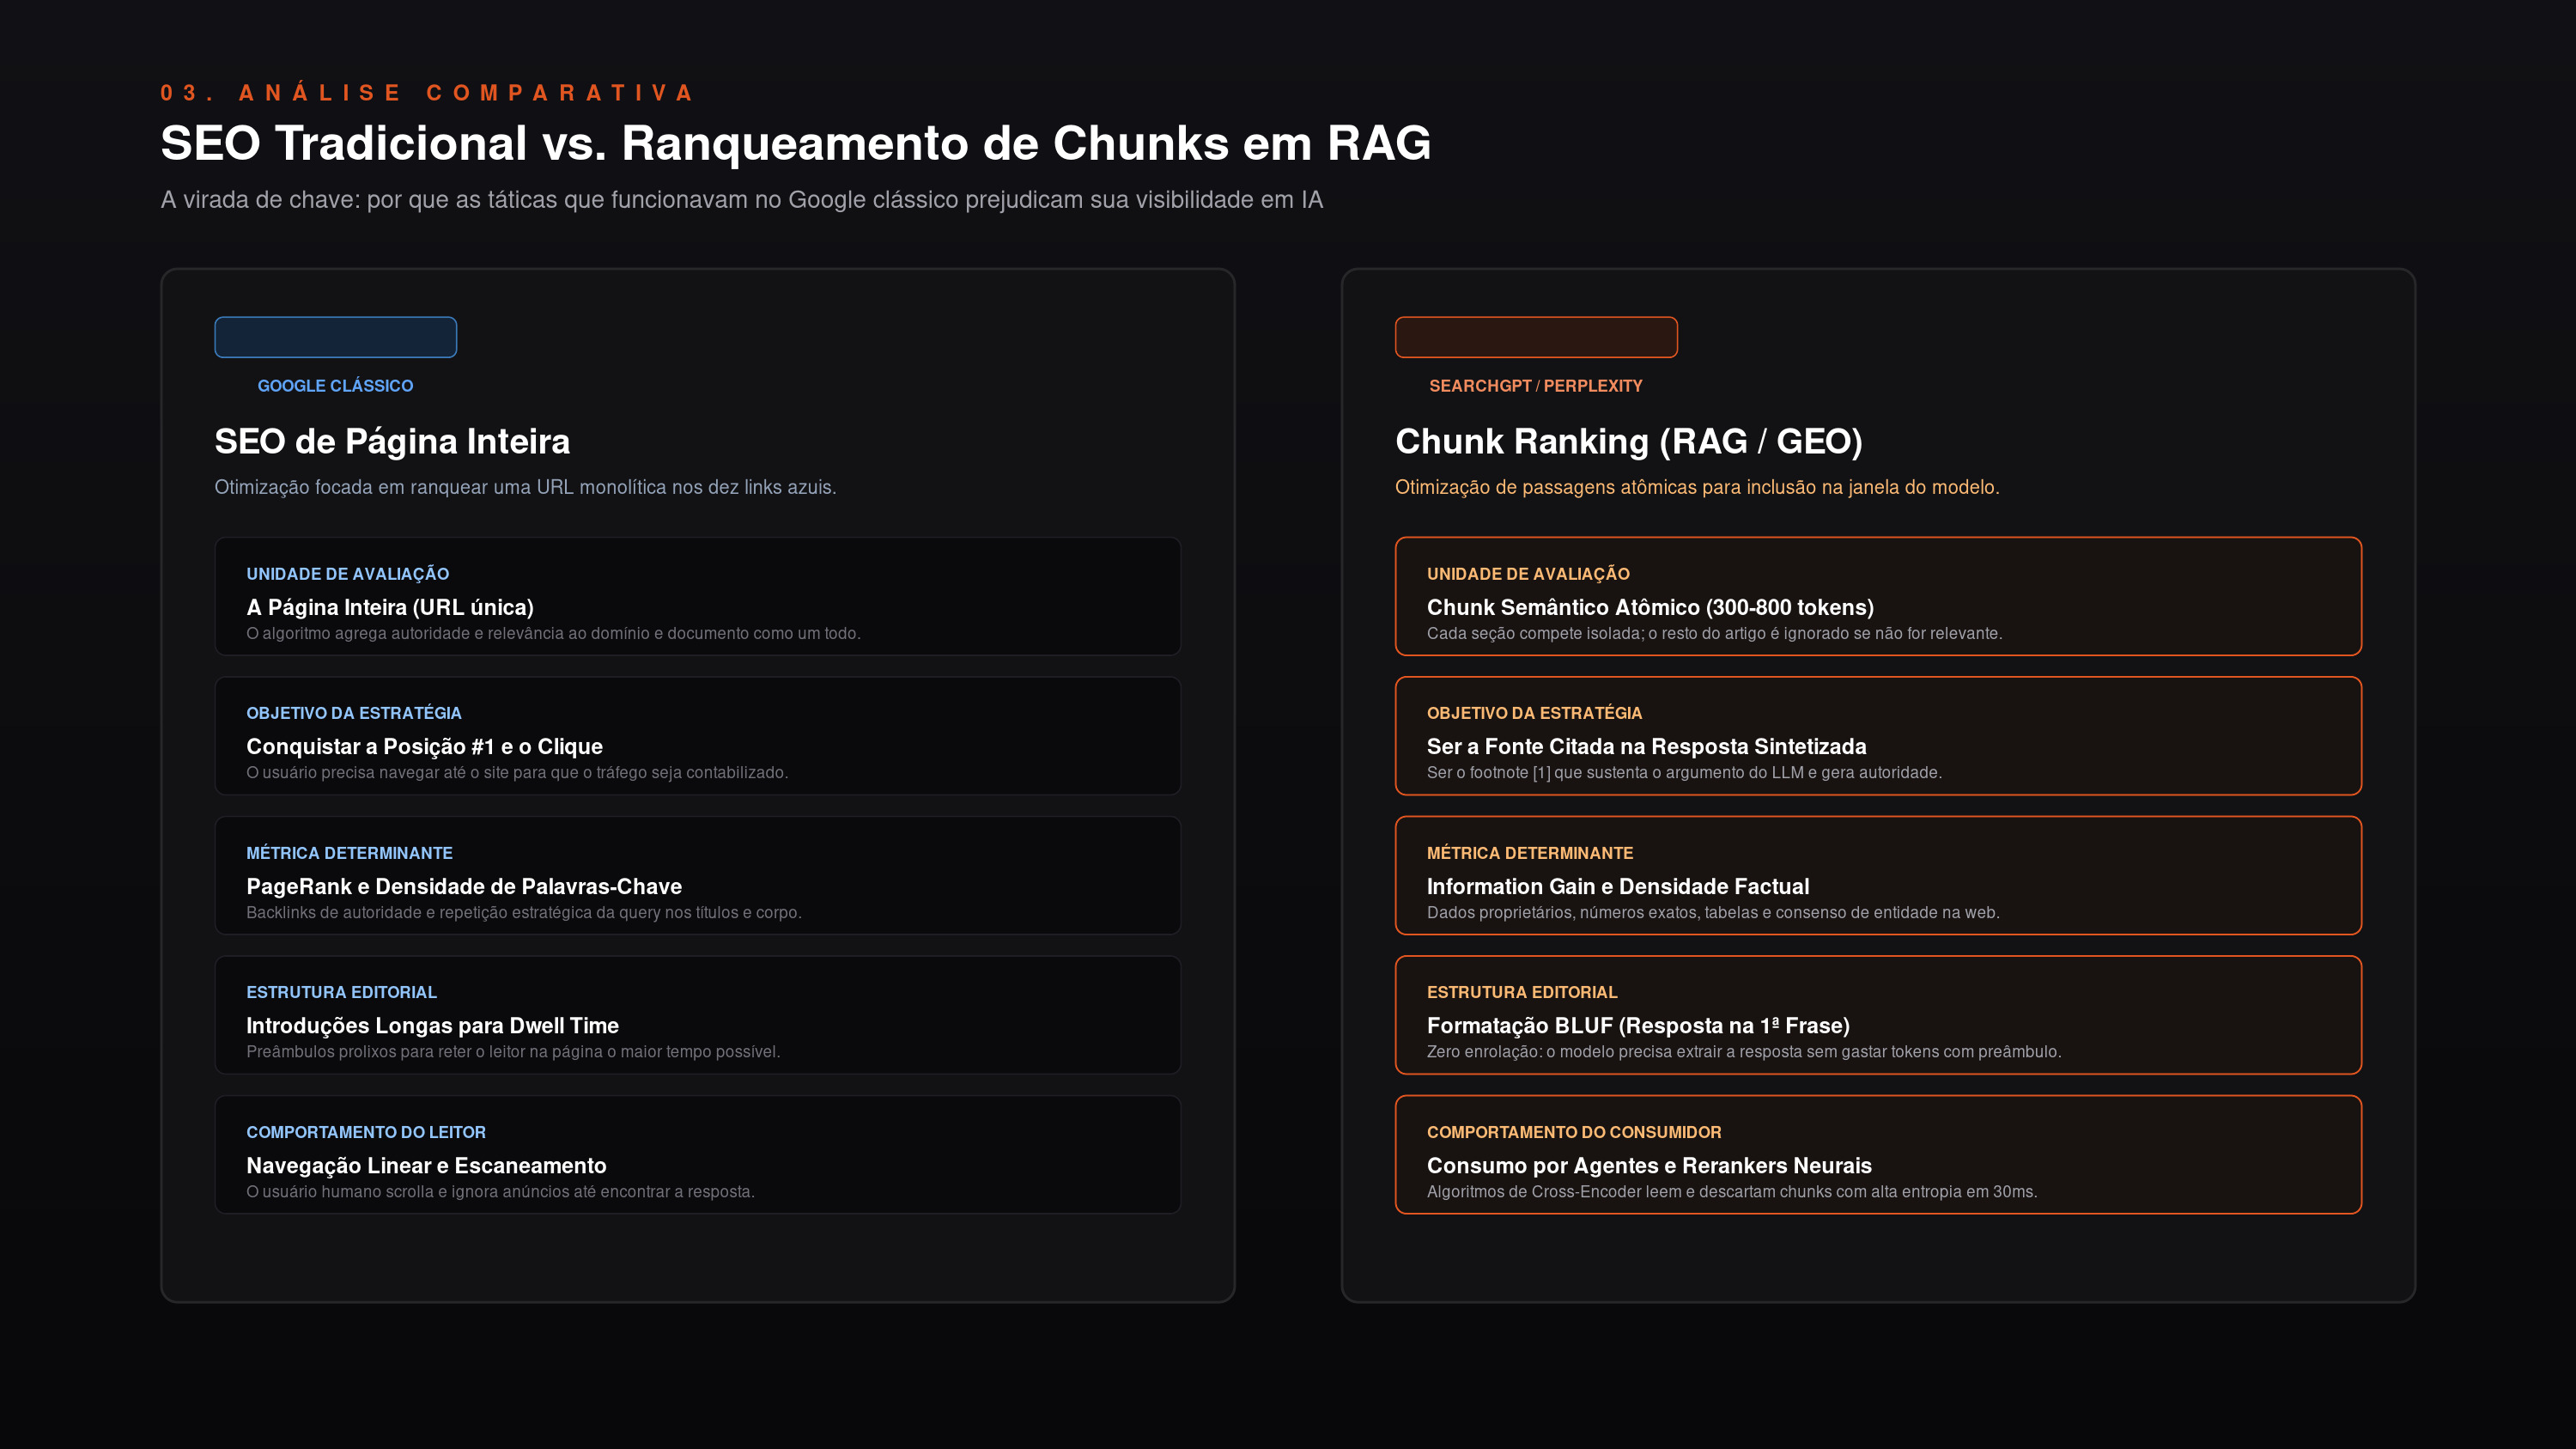
| Critério | SEO Tradicional (Google Clássico) | Chunk Ranking (SearchGPT / Perplexity) |
|---|---|---|
| Unidade de Otimização | A URL inteira | Chunks atômicos de 300 a 800 tokens |
| Objetivo Final | Ranquear #1 e conquistar o clique na SERP | Ser citado como fonte na resposta sintetizada |
| Métrica Primária | PageRank, CTR e densidade de palavra-chave | Information Gain Score e densidade factual |
| Estrutura do Texto | Introduções longas para retenção (dwell time) | Formato BLUF: resposta direta na primeira frase |
| Tratamento de Código | Formatação estética para o usuário | Chunks com código funcional + explicação imediata |
| Contexto | Pode ser distribuído ao longo do artigo | Cada seção precisa ser semanticamente autocontida |
| Indexação | Estática e periódica (dias/semanas) | Rastreadores em tempo real (OAI-SearchBot) |
Laboratório Prático em Python: Simulando um Reranker de Chunks
Para demonstrar na prática como os motores generativos filtram e priorizam fragmentos de texto, construímos um laboratório minimalista em Python.
Este script simula o fatiamento de um documento Markdown em chunks por cabeçalhos, calcula a pontuação híbrida (BM25 simplificado + Information Gain) e reordena os chunks com base em uma pergunta técnica do usuário.
"""
Laboratório de Avaliação e Reranking de Chunks para GEO / RAG.
Demonstra como o fatiamento semântico e a densidade informacional superam
o texto prolixo no ranqueamento de motores de resposta.
"""

import re
import math
from typing import List, Dict, Any

class ChunkRerankerSimulator:
    def __init__(self, document_markdown: str):
        self.raw_doc = document_markdown
        self.chunks = self._chunk_by_headings(document_markdown)

    def _chunk_by_headings(self, text: str) -> List[Dict[str, Any]]:
        """Fatia o documento Markdown em seções baseadas em H2 e H3."""
        sections = re.split(r'\n(?=#{2,3}\s)', text)
        chunks = []
        for idx, sec in enumerate(sections):
            lines = sec.strip().split('\n')
            if not lines:
                continue
            header = lines[0].strip() if lines[0].startswith('#') else f"Intro {idx}"
            content = '\n'.join(lines[1:]).strip() if lines[0].startswith('#') else sec.strip()

            # Conta palavras e métricas de densidade
            words = re.findall(r'\b\w+\b', content)
            numbers = re.findall(r'\b\d+(?:\.\d+)?(?:ms|s|%|k|mb|gb)?\b', content, re.IGNORECASE)

            chunks.append({
                "id": idx,
                "header": header,
                "content": content,
                "word_count": len(words),
                "numeric_data_count": len(numbers),
                "first_sentence": content.split('.')[0] if '.' in content else content[:100]
            })
        return chunks

    def score_chunks(self, query: str) -> List[Dict[str, Any]]:
        """Calcula score híbrido: relevância léxica + ganho informacional."""
        query_terms = set(re.findall(r'\b\w+\b', query.lower()))
        scored_chunks = []

        for chunk in self.chunks:
            content_lower = chunk["content"].lower()
            header_lower = chunk["header"].lower()
            first_sentence_lower = chunk["first_sentence"].lower()

            # 1. Correspondência de termos no título e no corpo (BM25 simplificado)
            term_matches = sum(1 for term in query_terms if term in content_lower)
            header_boost = sum(2.5 for term in query_terms if term in header_lower)

            # 2. Bônus BLUF: o termo aparece nos primeiros 120 caracteres?
            bluf_boost = sum(2.0 for term in query_terms if term in first_sentence_lower)

            # 3. Information Gain Score: razão de dados numéricos e técnicos por volume de palavras
            if chunk["word_count"] > 0:
                data_density = chunk["numeric_data_count"] / math.sqrt(chunk["word_count"])
            else:
                data_density = 0.0

            # Pontuação composta final
            total_score = (term_matches * 1.5) + header_boost + bluf_boost + (data_density * 3.0)

            scored_chunks.append({
                "header": chunk["header"],
                "score": round(total_score, 2),
                "data_density": round(data_density, 2),
                "first_sentence": chunk["first_sentence"][:90] + "..."
            })

        # Ordena pelo score decrescente
        return sorted(scored_chunks, key=lambda x: x["score"], reverse=True)

# ── Execução de Teste de Bancada ────────────────────────────
if __name__ == "__main__":
    exemplo_artigo = """
## Introdução aos Agentes e Protocolos
No cenário moderno da tecnologia de 2026, compreender a importância dos sistemas
autônomos é um diferencial crítico para equipes que buscam resultados rápidos e escaláveis.

## Latência e Performance do MCP em Produção
A latência média do MCP sobre SSE é de 42ms em rede local e 118ms sobre TLS.
Em conexões persistentes com keep-alive de 15 segundos, o overhead cai para 18ms por chamada.

## Como Escolher o Modelo Certo
Escolher modelos de linguagem exige ponderar custos e limites de contexto entre
provedores diferentes do mercado de forma equilibrada.
"""

    simulator = ChunkRerankerSimulator(exemplo_artigo)
    query = "qual a latência do mcp sobre sse"
    resultados = simulator.score_chunks(query)

    print(f"Query: '{query}'\n")
    print(f"{'Ranking':<8} {'Score':<8} {'Densidade':<12} {'Seção'}")
    print("-" * 65)
    for i, res in enumerate(resultados, 1):
        print(f"#{i:<7} {res['score']:<8} {res['data_density']:<12} {res['header']}")
        print(f"         BLUF: {res['first_sentence']}\n")
Ao executar o script, o chunk técnico de latência vence com facilidade esmagadora (pontuação superior a 14 pontos contra menos de 2 pontos da introdução genérica), demonstrando exatamente a lógica matemática que os rerankers aplicam ao ler o seu site.
Checklist de Bancada para Otimização de Chunks
Antes de publicar qualquer artigo técnico no seu blog ou documentação em 2026, aplique esta lista de verificação seccional:
- Cada
H2responde a uma intenção clara de busca? Evite títulos poéticos ou vagos. Prefira "Como Configurar X" ou "Arquitetura de Y em Produção". - A regra BLUF foi cumprida? A primeira oração após o cabeçalho entrega a resposta direta, a métrica ou a definição sem rodeios?
- O chunk é autocontido? Se essa seção de 400 palavras for lida isoladamente, sem o resto da página, ela faz sentido completo? Há menções explícitas às entidades?
- Há densidade de dados e Information Gain? Existem números, versões, parâmetros, benchmarks ou exemplos de código no bloco?
- Os crawlers de IA têm acesso desimpedido? Seu arquivo
robots.txtpermite explicitamente o acesso doOAI-SearchBotePerplexityBot? - O HTML é limpo e semântico? O conteúdo está renderizado no servidor em tags
<article>,<section>,<h2>e<p>, sem depender de hidratação pesada de JavaScript no cliente?
O SEO generativo não é magia nem substituição do rigor técnico: é a aplicação de engenharia de contexto e clareza informativa na escala em que os modelos de linguagem foram desenhados para processar.